做 RAG 知识库用什么向量数据库?小团队选型指南(自建 vs 托管)
小团队做 RAG 知识库,向量数据库选型看三件事:数据量、运维能力、预算。本文对比自建开源向量库、数据库插件和托管服务,并给出从零搭一个 RAG 检索的步骤。
结论先说:数据量在百万条以内、团队没有专职运维的,直接用托管向量数据库最省事;已经在用 PostgreSQL、数据量小的,可以先用 pgvector 插件起步;只有数据量上千万、对延迟和成本极度敏感,才值得自建 Milvus 这类集群。下面展开说怎么判断,以及一个 RAG 检索到底要搭哪几步。
向量数据库在 RAG 里干什么
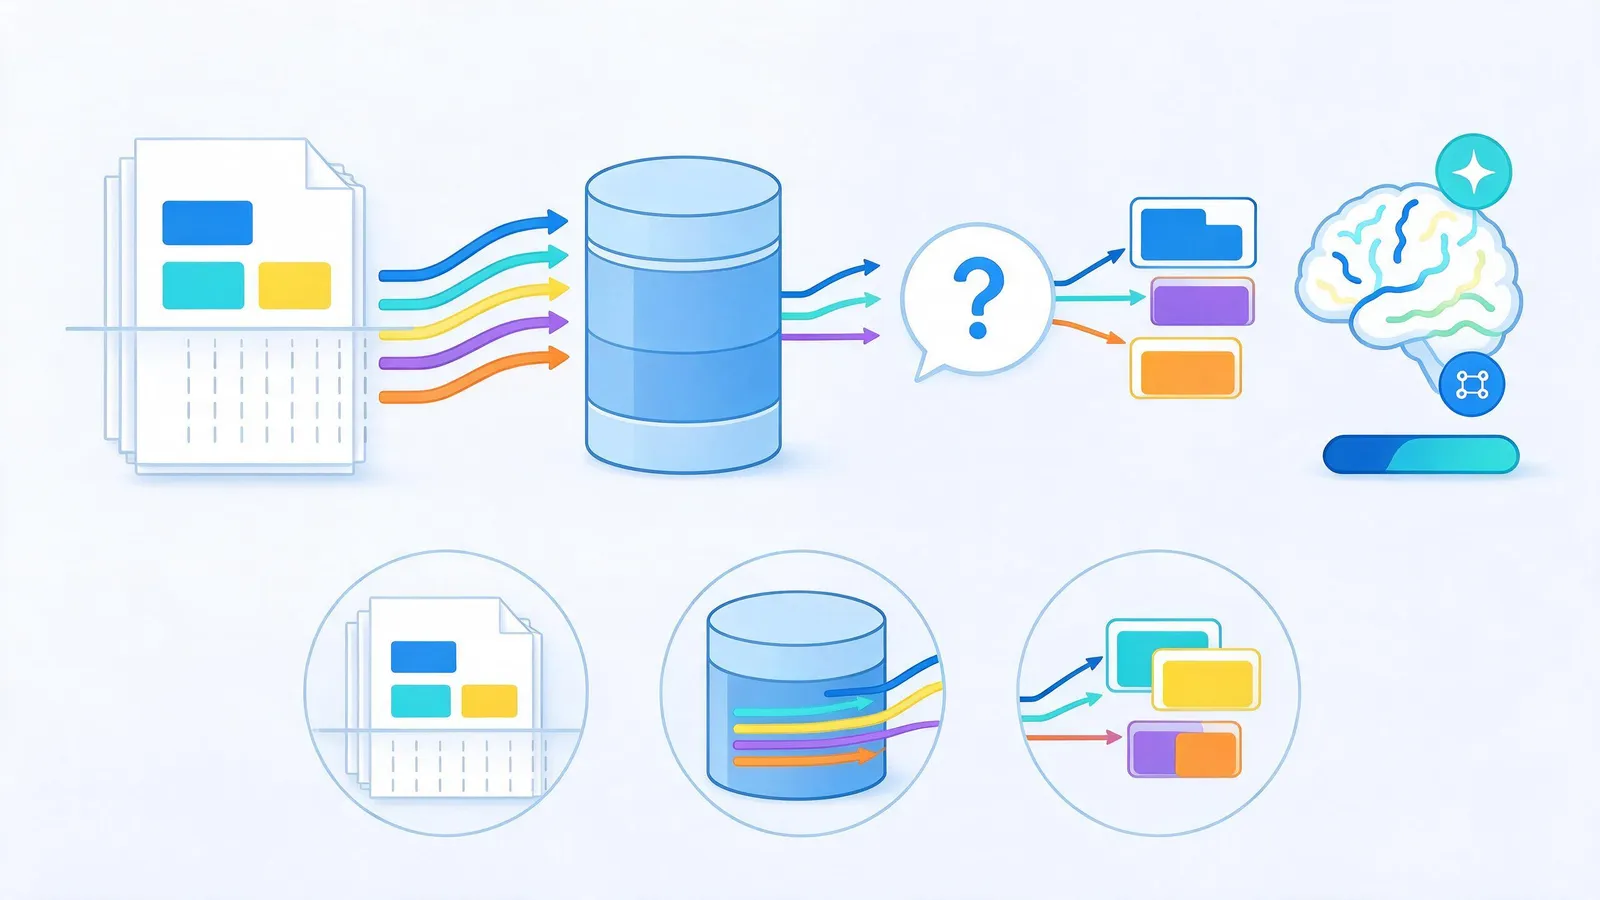
RAG(检索增强生成)的思路是:用户提问时,先从你的资料里找出最相关的几段,再连同问题一起交给大模型回答。「找最相关的几段」靠的就是向量检索:
- 把文档切成段落,用 Embedding 模型把每段转成一串数字(向量);
- 存进向量数据库;
- 用户提问时,把问题也转成向量,在库里找语义最接近的几段。
关键词搜索找不到「换个说法」的内容,向量检索按意思找,这是 RAG 回答准不准的基础。
三种选择怎么比
| 方案 | 代表 | 适合谁 | 主要成本 |
|---|---|---|---|
| 自建开源向量库 | Milvus、Qdrant、Weaviate | 数据量大、有运维人手 | 服务器 + 部署升级 + 备份监控 |
| 数据库插件 | PostgreSQL + pgvector | 已有 PG、数据量小 | 和业务库抢资源,量大后调优麻烦 |
| 托管服务 | 云厂商向量服务、不墨DEV 向量盒子 | 小团队、想快速上线 | 按量付费 |
小团队最容易低估的是运维成本:自建向量库不只是装上就完,还要考虑内存规划、索引参数、版本升级、数据备份和故障恢复。一个人兼职维护,出问题时往往就是知识库整体不可用。
选型时要问自己的 4 个问题
- 数据量多大? 几万到几十万条段落,任何方案性能都够;上千万才需要认真比较索引和集群方案。
- 用哪个 Embedding 模型? 不同模型的向量维度不同,选库时确认支持自定义维度。
- 有没有人运维? 没有就别自建。
- 数据要不要隔离? 多个项目或客户共用时,需要按集合划分和基于 Key 的权限控制。
从零搭一个 RAG 检索:4 步
以 不墨DEV 向量盒子 为例:
第一步:创建集合。 在控制台新建一个集合,向量维度填你所用 Embedding 模型的输出维度。
第二步:切分文档。 按段落或按 300~800 字切片,相邻片段保留少量重叠,避免一句话被切断后语义丢失。
第三步:向量化并写入。 用 Embedding 模型把每个片段转成向量,连同原文和来源信息通过 API 写入集合。
第四步:检索并拼进提示词。 用户提问时,先把问题向量化,检索出最相似的 3~5 段,再和问题一起拼进大模型的提示词。
常见问题
向量数据库能代替传统数据库吗? 不能。它擅长按语义找相似内容,订单、用户这类结构化数据还是放在关系型数据库里。
检索结果不准怎么办? 先检查切片大小和 Embedding 模型是否适合你的语言(中文资料优先选对中文优化的模型),再考虑加关键词检索做混合召回。
托管服务贵不贵? 按实际用量付费,个人项目和小团队的数据量通常花费很低,比单独租一台大内存服务器自建便宜得多。
总结
小团队做 RAG,先别急着自建集群:数据量不大时,托管向量数据库能让你把精力放在切片策略和提示词上,这才是决定回答质量的地方。
在不墨DEV 向量盒子创建你的第一个集合,开箱即用、按需付费。